重磅上线!PixTV 视频去字幕,自动处理与手动框选双模式登场
一段人物走出店铺的街景视频,光线、服装和环境都很完整,画面下方却留着一行原字幕。如果要换成自己的文字,直接叠上去会挤,裁掉下沿又可能影响构图。拿这样的素材看 PixTV 视频去字幕,最直观的关注点就是:能不能把处理目标放在那行字上,让后续排版更从容。

字幕在哪里,就先把注意力放在哪里
处理之前,先把视频从头看一遍,确认字幕的位置和范围。这条街景视频里,文字主要位于人物身前偏下的位置,背景还包括衣物与店铺环境。知道字幕经过哪些内容,才方便决定选区应该覆盖多大,也能在处理之后找到需要重点检查的画面。
PixTV 提供自动去字幕和手动框选两种模式。对于画面里位置明确的一行文字,手动框选很直观:把矩形区域放到字幕所在位置,再调整边界,让需要清理的文字落在里面。界面里的选框把这次任务表达得很清楚,操作时不用一直想着整张画面,只需先把区域定准。
从框选到处理,目标始终是下方这行字
街景片段中,矩形选区先覆盖字幕,再进入处理状态。顺着画面看下去,原来显示文字的位置逐渐空出来,人物和店铺仍然是镜头的主体。对准备重新配文的人来说,这个变化很实在:原字幕不再占着阅读位置,新文字就有了重新安排的余地。
框选时可以留意字幕两端和上下边缘,尤其是字形较高、存在标点或分成两行的情况。选区是否合适,要以完整覆盖目标文字为出发点。遇到字幕中途换位置的视频,也要先观察它的变化,再决定处理方式,避免只看开头一帧就判断整条素材。

图1|手动框选示意:将处理区域对准画面下方的原有字幕。
清理之后,重新考虑文字怎么进画面
原文字区域整理好之后,接下来就可以重新安排文案。这条街景镜头很适合用来思考两种方向:保留人物出门的情绪,配一句短文案;或者围绕服装、场景展开介绍,让字幕承担更多信息。同一段画面的气质没有变,文字的表达重点却可以重新选择。
新字幕放在哪里,要继续结合人物的动作看。手部、腰部的穿搭细节、行走方向,都可能成为观众正在看的内容。可以先确定哪些位置值得留给画面,再安排字号与断行。这样做出来的新版会更像一条重新组织过的内容,观看顺序也更清楚。
自动模式也可以作为处理入口,具体选择取决于素材。对于字幕区域清楚、需要自己指定位置的内容,手动框选的好处是目标可见。操作前知道自己要清理哪里,处理后也容易对照同一位置,整件事从开始到检查都有一个清晰的关注点。
真正决定能否采用的,是连续观看感受
看处理结果时,可以先停在字幕区域核对边缘,再播放整段视频观察人物经过时的变化。衣物、玻璃和建筑线条都属于值得留意的细节。截图能帮你找到检查位置,连续回放则能看出运动中的观感,两者结合,才更容易判断这段素材适合怎样使用。

图2|GIF 后段展示同一场景字幕区域的处理状态;这是一段功能演示,具体画质需结合原素材检查。
这种操作很适合那些画面本身已经合适、只是原字幕与新内容不匹配的短片。把文字区域先整理出来,后续创作就能重新回到选题、节奏和排版上。对经常给同一素材做不同版本的人来说,这是一项很容易放进日常制作流程的功能。
有喜欢的镜头,却不想沿用原字幕,可以前往 PixTV 选择适合素材的处理方式。体验:http://pixtv.art。从整理字幕区域开始,为新文案留出位置。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。



- PriceSeek提醒:10月27日山东地区己二酸报价回落_焦点速讯
- 自由航海与硬核海战:加勒比海盗类战斗手感好的几款游戏
- 焦点速读:宠物成了骗保工具 数家宠物医院卷入其中
- 亚洲水泥(中国)(00743)前三季度股东应占亏损3.01亿元-聚焦
- 慢火车不挣钱,为什么还要开?
- 债市日报:10月27日_热头条
- 大摩:维持裕元集团(00551)“与大市同步”评级 目标价12.5港元
- 港股午评:高开低走!恒指跌0.14%,科网股、中资券商股齐跌_焦点日报
- 每日观点:“微光计划”第二季启动 关爱骨与软组织罕见肿瘤患者
- 每日讯息!今年前三季度中国对德国进出口1.2万亿元
- 有哪些适合剧情党玩的 3A 游戏?三款叙事大作剧情深度横评
- 焦点关注:哥伦比亚记者社媒晒个人金球奖投票顺序引发争议,随后删帖
- 生意社:10月27日吕梁市场铸造焦价格暂稳运行|头条
- 【快播报】国信证券:首次覆盖粤港湾智算给予“优于大市”评级 合理估值15.53港元至17.09港元
- [快讯]豫园股份发布质押公告|今日要闻
- 股市面面观丨不惧融资余额持续下降 资金10月借道ETF入市热情高涨-速读
- 当前看点!10月27日尿素期货收盘上涨0.36%,报1686元
- 当前信息:诚达药业:截至9月30日最新股东户数1.64万户,较上期增加1.79%
- 图解财报:江盐集团前三季归母净利润4089.42万元,同比减少79.11%
- 扬农化工创新药上市 农产品涨价 农化景气上行启动
- 看热讯:生意社:10月27日鲁西化工新戊二醇价格趋稳
- 财知道|PPOP是什么?银行利润的“卸妆水” 每日快报
- 商务谈判延期公告
- DoorDash(DASH.US)最有望接手Instacart(CART.US),分析师:该组合是抗衡亚马逊、沃尔玛的“最优解”-新动态
- 电科院前三季度净利润同比扭亏 扣非净利润增长178.52%
- 打爆广厦队,辽宁队大调整,杨鸣宣布最新决定 焦点速讯
- 蒙牛:终止与姆巴佩合作,坚决抵制、零容忍;姆巴佩发表不当言论,多品牌下架其物料,虎扑拿掉姆巴佩金球奖排名、懂球帝发布声明-每日快报
- 今日观点!马斯克与黄仁勋观点打架 摩根大通:超大规模AI数据中心运营商状况良好是市场共识
- 每日热门:创业板指跌逾1% 科创50跌近2%
- 感谢那堂课,让我重新看见了自己|观速讯
- 华子47+4+4+2+2无缘今日最佳!对不起,你碰到创纪录的申京了_动态
- 或真成中超笑话!蓉城最后一轮若在客场丢冠,将创造4大名场面
- 持球大核的三位超巨,为什么只有詹姆斯成功夺冠了|今日快看
- 每日焦点!午评:沪指半日跌0.13% 零售板块走强
- 10月27日肝素概念板块跌幅达2%-观速讯
- 汇丰控股(00005)发布前三季度业绩 除税后利润229亿美元 同比增加28%
- 视焦点讯!华安期货:玻璃区间震荡观点
- 港股异动 | 中国人寿(02628)涨近3% 近日拟向控股股东出售所持养老险公司33.73%股权-热门看点
- 1.5L甲醇插电混动 外观升级 吉利银河星耀6EF将于11月3日上市 通讯
- 速递!刚开售就碎屏?iPhone Duo翻车原因曝光,质检标准太低
- 张一鸣登顶中国首富,6700亿元刷新中国首富财富纪录
- 中消协发布“双十一”消费提示
- 每日热闻!河南郑州文庙点亮时尚之夜
- 视讯!10月27日麒麟电池板块跌幅达2%
- 【券商聚焦】国金证券维持中通快递买入评级 指公司盈利韧性凸显
- 食品饮料板块异动拉升 桂发祥2连板 每日看点
- 北京丰台站增两条出站通道 去停车场、地铁站更快
- 焦点精选!人民日报:一些地区将12345热线满意率作为重要考核指标,导致部分工作人员只管追着群众要“好评”,不关心问题是否解决
- CBA:第五窗口期中国男篮集训名单已确定,广东一战暴漏三大短板,麦基留队希望不大-热头条
- 今热点:广东87-99仅过去一晚!传来徐杰、亚帅的重要消息,杨鸣说得很实在
- 大佛寺东街2、4、6号原属于一个大家族,跟富察·傅恒有关系
- 北交所融资融券余额78.10亿元,环比减少3134.24万元 今日关注
- 汽车零部件板块短线拉升 襄阳轴承等多股涨停
- 今热点:寒锐钴业:2026年前三季度计提减值1.11亿,Q3由盈转亏1.49亿、毛利率降至6.99%
- 动态焦点:火箭又遇伤病潮!海王又倒下了,乌度卡将重用2人,内线拉响警报
- 今日关注:破案了!姆巴佩“不当言论”曝光,暴露皇马问题,确实有些过了
- 卡里克位置不保!曼联瞄准世界级名帅!冠军教头碾压埃迪·豪
- 《四川集中式新能源发电企业集中报价实施方案(试行)》发布_热资讯
- 今日精选:2026襄阳马拉松鸣枪开跑 八成多选手来自外地 2万跑友首次穿越古城中轴线
- 观热点:新平县肸源建筑材料经营部(个体工商户)成立 注册资本20万人民币
- 中信建投:建议关注高速光模块、AI服务器及数据中心配套-焦点短讯
- 三季度做市商评价出炉, 11家券商获“减免”资格!
- 微速讯:官宣!金球奖得主出炉
- 焦点速读:太阳报:阿森纳邀请患癌小球迷观赛,助其筹集治疗费
- 报道:12306上线新功能 买团体票更方便
- 10月26日通信ETF银华基金份额减少1.22亿份,重仓股新易盛、中际旭创、立讯精密
- 焦点!央行宣布设立债市非银大额赎回互换便利 完善非银机构应急流动性安排,构建“股市+债市”稳市机制
- 时讯:2026金球奖揭晓 凯恩首度获奖
- 恒指牛熊街货比(46:54)︱10月27日_每日热门
- 岱勒新材10月26日回应折叠屏话题:惠州公司折叠屏新品加工业务9月底起满产 当前聚焦
- 最资讯丨周一热门美股、中概股收盘一览
- 普宁市铭诚鑫电器有限公司成立 注册资本10万人民币
- 焦点播报:私募业管理规模 增至25.83万亿元
- 微软拟向约6万名员工提供自愿离职方案|当前热讯
- 米克尔:阿隆索应给埃斯特旺更多机会,避免他赛季末离队
- 当前信息:杭州降39%、广州降32%、上海降31%!不是房子卖光了,是房东不卖了
- 【焦点热闻】江西日恒新材料有限公司成立 注册资本50万人民币
- 日丰股份(002953.SZ)新增一起对外投资,被投资公司为广东日丰光电科技有限公司
- 拓维信息(002261)2026年三季报简析:增收不增利,公司应收账款体量较大-焦点播报
- 八环科技冲刺北交所:三十年匠心铸就国家级单项冠军
- 热讯:一场1:2皇马!他是巴萨输球最大罪人!弗里克收获两个坏消息
- 大坂直美:不排除会因为女儿而选择退役,自己距离赢得大满贯时的状态并不遥远 今亮点
- 焦点速看:铁路12306上线新功能 买团体票更方便
- 股票行情快报:獐子岛(002069)10月26日主力资金净买入315.38万元
- 每体:埃斯帕特右脚踝已有旧伤,恰好被楚阿梅尼击中伤处
- 【速看料】11年西部半决赛雷霆抢七胜灰熊,黑白双熊场均38+22,雷霆三少呢
- “廿九”的“廿”,不读gān,我就没看到有人读对!
- 我和医生“对个表” 错峰就医更便捷
- 【新视野】俊朗股份2026年上半年净利1310.39万同比增长20.86% 销售费用较上年同期增加
- CPT Markets:金矿深部钻探推进评估
- 华联控股(000036.SZ)发布前三季度业绩,归母净利润2939.9万元,同比下降17.61%
- 加拿大丰业银行:将微软目标价上调至625美元 每日视点
- 中国心连心化肥(01866)前三季度归母净利润约11.38亿元,同比增长42% 热推荐
- 宇树科技,再次提示风险|即时看
- 即时看!天星医疗(01609.HK)发布公告,于2026年10月23日斥资42.67万港元回购8000股
- PriceSeek提醒:10月26日山东金岭二氯甲烷出厂价上调
- 石药集团(01093.HK):安尼妥单抗联合注射用多西他赛(白蛋白结合型)(HB1801)用于HER2阳性晚期乳腺癌一线治疗的III期临床研究结果于2026年ESMO年会上以优选口头报告形式公布及同步发表于《新英格兰医学杂志》
- 信息:达瑞电子龙虎榜数据(10月26日)
- 都市丽人(02298.HK)获执行董事吴小丽增持122万股
- 今日热搜:远大健科龙虎榜:营业部净卖出2855.17万元
要闻排行
-
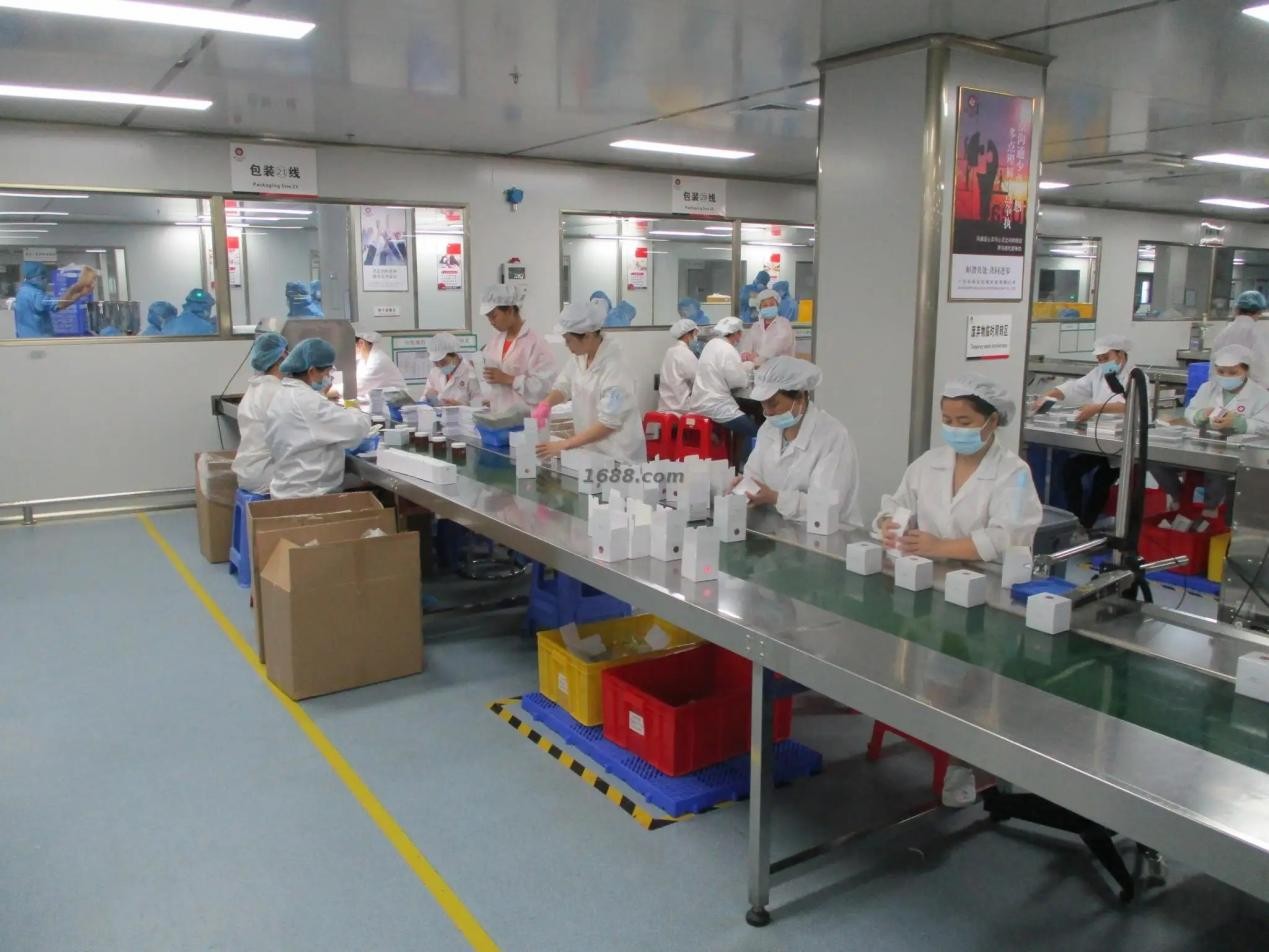 大力推动美妆市场的变革泉意品牌义不容辞
-
 海外直播带货正当潮!维卓旗下润杨力量获TikTok TSP官方认证资质
-
 打破技术壁垒 得力彩色喷墨打印机的自研之路
-
 “干面荟”出圈之路,创新的背后是要读懂年轻人!
-
 爆款预定!瑞虎7 PLUS新能源渲染图曝光,双拼内饰,还有超大尺寸双联屏
-
 预定爆款!智慧先锋科技+领潮先锋造型,打造瑞虎7 PLUS新能源超强竞争力!
-
 高通钱堃:保持与中国产业高度融合,推动5G创新,共创数字未来
-
 预定爆款!搭载骁龙8155芯片/L2+级智能驾驶辅助系统,瑞虎7 PLUS新能源耀目成都车展
-
 限时盲订开启!全新欧蓝德成都车展公布配置,携手阿根廷国家足球队威风启程
-
 享10000份盲盒赢8888元整家免单! 掌上明珠国货焕新家盛惠来袭!
精彩推荐
- 阿森纳点球4-6弗利特伍德,13年梦魇再现-热文
- 热文:绿春县滇爷原酿果酒果汁醋经营部(个体工商户)成立 注册资本10万人民币
- 我国首个智慧货运枢纽领域国标发布
- 三 力 士:截至2026年10月20日,公司的股东人数为46609名
- 每日精选:前三季度规模以上工业企业利润实现较快增长
- A股分红派息转增一览:2股今日股权登记
- 老干妈用AI降本增效,可拣椒工去哪了?企业辟谣背后,最该补上的那一页是“人怎么办”!
- 滚动:无硬盘版2059元起:铭凡M2 Slim迷你主机开售,酷睿3 304处理器
- 药捷安康-B(02617.HK)购回32,500股 耗资280,290.01港元
- 人民鉴真192期丨赛福天:人形机器人腱绳相关产品尚处于研发及客户送样验证阶段 未形成相应收入|每日报道
超前放送
- 重磅上线!PixTV 视频去字幕,...
- 抢先体验!PixTV 视频延长升级...
- 500倍身价差距!星空体育:英乙...
- 每日热闻!沙利文:阿里云占中国...
- 轰27+20救主,难怪敢拒5年2亿!...
- 热消息:外国网友:中国是第一个...
- 跑代码易,做任务难:AI编程迎来...
- 每日动态!四人20+爆冷掀翻湖人!...
- 阿森纳点球4-6弗利特伍德,13年...
- 保隆科技、奇瑞汽车在芜湖成立智...
- 焦点速讯:21岁沈佳润写真,大胆...
- 焦点观察:申京受伤缺阵雄鹿,火...
- 2026年10月28日贵阳农产品物流园...
- 谷歌发布新一代世界模型Genie4,...
- 韩元自两年多高位回落 美元兑韩...
- 热文:绿春县滇爷原酿果酒果汁醋...
- 喜讯!向余望在社媒给球迷带来久...
- 推荐能造出很好看城市的城建游戏...
- 港元拆息个别发展 一个月息由跌...
- 新资讯:机构风向标 | 德美化...
- 中国互联网是否存在“字节时间”...
- 回应舆论风波!西甲官方公开表态...
- 前皇马队长卡瓦哈尔表示安切洛蒂...
- 我国首个智慧货运枢纽领域国标发布
- 蓉城在客场踢鲁能比赛时,或许能...
- 人行道电线杆歪了!市民担心安全...
- 三年产学研转化 相干科技探索超...
- 实时:佛山市恒岭木业有限公司成...
- 文班29+10+5帽马刺轻取国王,尚...
- 前三季度1.6万个老旧小区“焕新”
